library(tidypptsda)
library(data.table)
res <- run_pipeline(nedap, verbose = 0)
本文逐一说明 tidypptsda
输出的每一张表、每一列的含义,以及怎么出图、导出 csv 和生成 HTML
报告。体重单位为
kg,日增重(ADG)和日采食量(ADFI、dfi_*)单位为
g/d,日期为 Date 类型。
1. 结果的整体结构
run_pipeline()
返回一个列表,每个元素对应流程中的一步:
| 元素 | 来自 | 内容 |
|---|---|---|
$visits |
prep_visits() |
整理后的访问记录,每次访问一行 |
$weight |
clean_weight() |
体重质控结果 |
$adg |
calc_adg() |
日增重 |
$adfi |
calc_adfi() |
日采食量 |
$fcr |
calc_fcr() |
料肉比及最终结果 |
$removed |
各步汇总 | 被剔除的猪及原因 |
$weight、$adg、$adfi、$fcr
的结构相同,都包含:
-
per_pig:每头猪一行的结果; -
daily:每头猪每天一行的结果; -
removed:截至这一步被剔除的猪; -
settings:本次使用的全部质控参数(qc_config()的结果)。
部分步骤另有附加的表,下文分别说明。最常用的是
res$fcr$per_pig,它就是最终结果表。
head(res$fcr$per_pig[, .(responder, location, adg, adfi, fcr, fcr_flag, fcr_note)])
#>    responder location      adg     adfi      fcr       fcr_flag
#>       <char>   <char>    <num>    <num>    <num>         <char>
#> 1:     13913      101 1209.897 2642.654 2.184196             ok
#> 2:     13918      101 1162.966 2566.372 2.206747             ok
#> 3:     13954      101 1124.224 2681.418 2.385127 low_confidence
#> 4:     13996      101 1334.979 2860.245 2.142538             ok
#> 5:     14962      101 1278.746 2830.550 2.213536             ok
#> 6:     15006      101 1317.472 3121.544 2.369343             ok
#>                                   fcr_note
#>                                     <char>
#> 1:
#> 2:
#> 3: weight records cover 5.0 kg of 80-90 kg
#> 4:
#> 5:
#> 6:
2. $visits:整理后的访问记录
| 列 | 含义 |
|---|---|
responder |
耳标号(统一后的个体号;同一耳标被判为两个个体时改为
耳标_站号) |
responder_raw |
原始耳标号 |
identified |
是否为已识别的访问;未识别访问(耳标为 0 或缺失)保留下来,用于采食错误判定 |
location |
测定站编号 |
date、seq_days
|
访问日期;测定第几天(全批次第一天为 1) |
seq_in_day、seq_in_location
|
当天第几次访问(按猪);当天第几次访问(按站) |
entry_time、exit_time、duration
|
进入、离开时间;停留时长(秒) |
feed_intake |
单次采食量(g) |
weight |
访问时的体重(kg),0 已改为 NA
|
trough_in、trough_out、topup
|
进入、离开时的料槽重(g)和加料量(仅 FIRE 数据) |
breed |
品种(原始数据中有,或用 add_breed() 加入时才有) |
attr(res$visits, "stations")
每头猪一行,记录跨站情况:location_path(如
101>102>101)、main_location(访问最多的站)、n_locations、n_transfers(转栏次数)、transfer、misreads(转为未识别访问的误读次数)、longest_gap_days(最长无访问天数)和
weight_jump_kg(转栏前后扣除正常生长后的体重差,没有转栏时为
NA)。
3. $weight:体重质控
per_pig
| 列 | 含义 |
|---|---|
n_records、n_valid、n_outliers
|
体重记录数;有效记录数;判为异常(含适应期、范围外)的记录数 |
first_date、last_date、test_days
|
首条、末条有效体重的日期;两者之间的天数 |
missing_rate |
测定期内没有有效体重的天数占比 |
r2 |
有效体重对其 LOESS 平滑曲线的 R²(低于 smooth_r2_min
时降级) |
entry_weight、exit_weight
|
LOESS 平滑曲线在首条、末条有效记录处的体重 |
track_removed |
逐日回溯追踪剔除的记录比例(未追踪时为 NA) |
longest_gap_days |
最长无访问天数;超过 max_gap_days
时降级(测定中断,例如隔离治疗) |
weight_jump_kg |
转栏前后的体重跳变(来自 prep_visits());绝对值超过
max_jump_kg 时降级 |
status |
keep(通过)、low_confidence(保留但需注意)、removed(剔除) |
reason |
降级或剔除的原因 |
records:每一条体重记录
| 列 | 含义 |
|---|---|
entry_time、weight
|
访问时间和体重 |
fitted |
weight_outlier 中第一种方法的拟合曲线在该时刻的值 |
rlm_w |
稳健回归给这条记录的权重(0–1,越小越像异常值;未用 rlm 时为
NA) |
outlier |
是否判为异常(不参与后续计算) |
qc_flag |
判为异常的原因,空字符串表示正常,见下表 |
res$weight$records[, .N, by = qc_flag]
#>       qc_flag     N
#>        <char> <int>
#> 1: adaptation  3404
#> 2:            25805
#> 3:      track  1543
#> 4:  rlm;loess   328
#> 5:        rlm   310
#> 6:      loess    82
qc_flag |
含义 |
|---|---|
"" |
正常 |
adaptation |
进站适应期(adapt_days)内的体重,不参与分析 |
weight_range |
超出 weight_range
|
track |
逐日回溯追踪时与预测体重不衔接 |
rlm、loess、stl、sd
|
被相应的异常值方法判为异常(多种方法时用 ; 连接) |
4. $adg:日增重
per_pig
| 列 | 含义 |
|---|---|
stage |
计算区间,如 30-120
|
adg |
日增重(g/d):区间内每天的体重(实测 + 填充)对日期直线回归的斜率 |
r_squared |
这个回归的 R² |
n_observed_days、n_interpolated_days、n_curve_days
|
区间内日体重为实测、线性插值、生长曲线填充的天数 |
adg_curve |
对照用:生长曲线在区间两端的体重差 ÷ 天数 |
curve_used、curve_r2
|
实际使用的生长曲线和它的 R²;切线外推时注明,如
poly2 + tangent (start)(只在开头,默认)或
poly2 + tangent(两端) |
adg_type |
observed:区间两端都在测定期内;extrapolated:需要外推,但不超过
max_extrap_days;partial:外推后仍到不了端点,只算覆盖到的部分;none:覆盖不足
7 天,没有日增重 |
start_date、end_date
|
曲线到达区间下限、上限的日期(区间的起止) |
start_weight、end_weight
|
起止处的体重 |
stage_days |
区间天数 |
extrap_days_start、extrap_days_end
|
起点在首条记录之前、终点在末条记录之后,由生长曲线(或切线)外推的天数 |
weight_status、weight_reason
|
体重质控的结论(来自 $weight) |
5. $adfi:日采食量
daily:每头猪每天的采食
| 列 | 含义 |
|---|---|
bw |
当天体重($adg$daily 中补齐后的
weight_filled) |
in_stage |
是否在区间内 |
n_visits、n_error_visits
|
当天访问次数、有采食错误的访问次数 |
dfi_raw |
记录的日采食量(全部访问相加) |
dfi_error_free |
无错误访问的采食量之和 |
dfi_corrected |
用混合模型校正后的日采食量 |
dfi |
最终使用的日采食量(校正值,缺失的天为插补值) |
state |
这一天 dfi 的来源,见下表 |
state |
含义 |
|---|---|
org |
实测,当天没有错误访问 |
corr |
当天有错误访问,用模型校正 |
iii |
两个有记录的日子之间缺失:≤ 3 天用 LOESS,> 3 天用群体曲线 ×
个体比例(loess_lm 时为单猪回归,linear
时为线性插值) |
elrp |
区间两端缺失:首个记录日之前用群体曲线 ×
个体比例,末个记录日之后用单猪回归(loess_lm、linear
时两端都是单猪回归) |
missing |
无法估计 |
NA |
区间外的日子,不需要插补 |
per_pig
| 列 | 含义 |
|---|---|
adfi |
区间内日采食量的平均值(g/d) |
adfi_raw、adfi_error_free
|
未校正、仅无错误访问的平均日采食,供对照 |
n_stage_days |
区间天数 |
n_observed、n_corrected、n_interpolated、n_extrapolated、n_missing
|
各来源的天数 |
n_extrap_start、n_extrap_end
|
区间开头、结尾连续用回归填充的天数 |
coverage |
有实测(含校正)采食的天数占区间天数的比例 |
6. $fcr:料肉比与最终结果
per_pig
| 列 | 含义 |
|---|---|
adg、adfi
|
日增重、日采食量(g/d) |
fcr |
料肉比 = adfi ÷ adg
|
gf |
饲料效率 = adg ÷ adfi
|
adg_type、coverage、stage_days、start_weight、end_weight
|
同上文 |
extrap_days_start、extrap_days_end、n_extrap_start、n_extrap_end
|
体重、采食量在区间两端的填充天数 |
fcr_flag |
ok(可信)、low_confidence(低可信度)、NA(没有料肉比) |
fcr_note |
低可信度的原因,例如外推天数过多、采食实测比例不足、某体重段记录断档等 |
7. $removed:被剔除的猪
| 列 | 含义 |
|---|---|
responder、location
|
耳标号、测定站 |
step |
在哪一步被剔除:prep_visits(读卡误读,访问已转为未识别访问,猪本身不剔除)、clean_weight(体重质控)、calc_adg(没有日增重)、calc_adfi(没有日采食) |
reason |
原因 |
res$removed
#>    responder location         step               reason
#>       <char>   <char>       <char>               <char>
#> 1:     15964      101 clean_weight 0 valid weights < 20
8. 导出为 csv
write_results(res, dir, farm) 把结果写成 csv:
res <- run_pipeline(fire, qc = qc_config(stage_range = c(60, 120)))
write_results(res, dir = "结果", farm = "A01")
文件按”场名_内容_日期.csv”命名,例如
A01_fcr_20261022.csv。全部文件如下:
| 文件 | 内容 | 对应的表 |
|---|---|---|
fcr |
每头猪的 ADG、ADFI、FCR 和可信度标记 | res$fcr$per_pig |
by_bin |
每个体重段的采食、增重和分段料肉比 | res$fcr$by_bin |
daily_feed |
每天的采食量(原始、校正、插补) | res$adfi$daily |
daily_weight |
每天的体重(实测、填充和生长曲线) | res$adg$daily |
weight_pigs |
每头猪的体重质控结果 | res$weight$per_pig |
feed_model |
采食校正模型的系数 | res$adfi$model |
summary |
性状汇总统计 | res$fcr$summary |
removed |
被剔除的猪及原因 | res$removed |
settings |
本次使用的全部质控参数,每个参数一行 | — |
文件带有 UTF-8 BOM,用 Excel 直接打开时中文不会乱码。
9. 作图
g <- plot_adg(res$adg, weight = res$weight, responders = c("13913", "13954", "15967"), verbose = 0)
g$plot[[1]]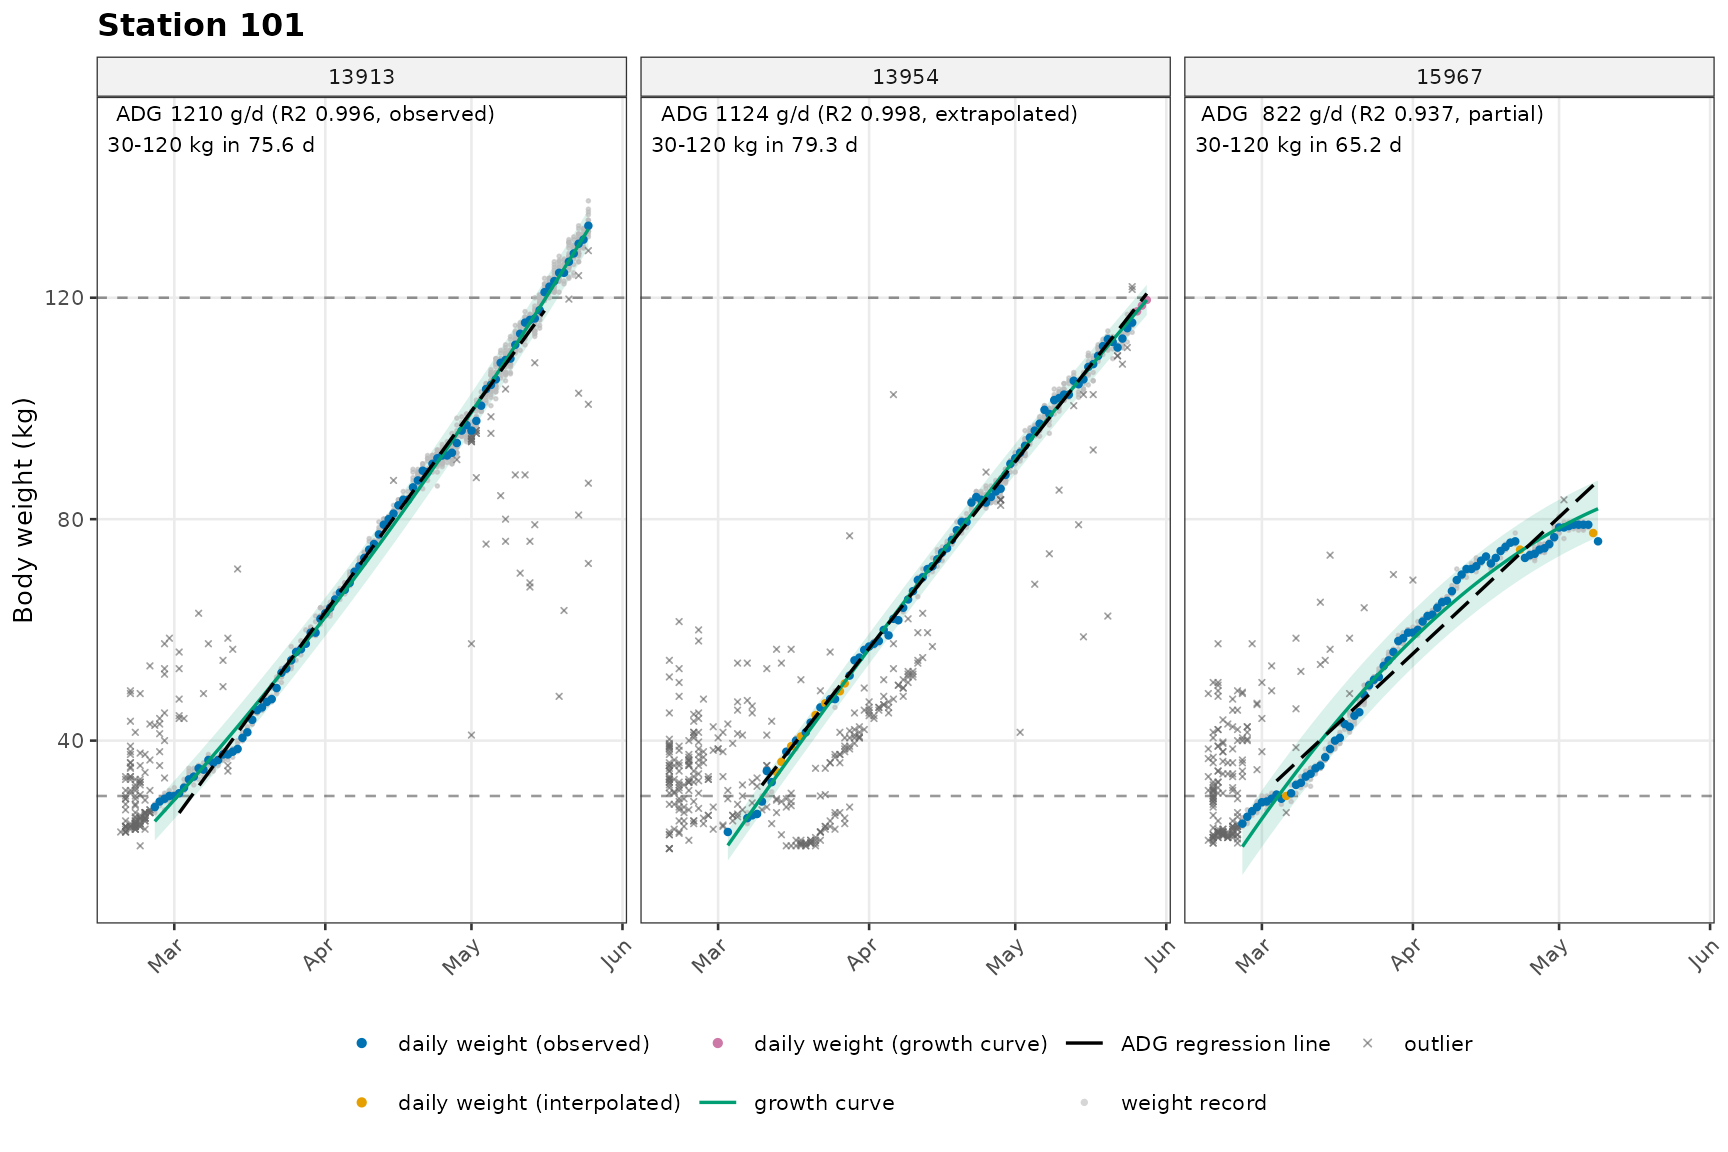
生长曲线图怎么看
每个测定站一张图,每头猪一个分面:
| 图中元素 | 图例 | 含义 |
|---|---|---|
| 浅灰色小点 | weight record | 有效的原始体重记录(传入 weight = res$weight
时才画) |
| 深灰色小叉 | outlier | 被剔除的原始记录:适应期、超出体重范围、追踪剔除、rlm 或 LOESS
判为异常,原因见 res$weight$records$qc_flag
|
| 蓝色点 | daily weight (observed) | 实测日体重:当天有效记录的中位数 |
| 橙黄色点 | daily weight (interpolated) | 两个有记录的日子之间缺失的日子,线性插值 |
| 紫红色点 | daily weight (growth curve) | 首个有记录日之前、末个有记录日之后缺失的日子,用生长曲线填充 |
| 绿色实线和浅绿色带 | growth curve | 生长曲线及其约 95% 范围(±1.96 倍残差标准差) |
| 黑色长虚线 | ADG regression line | 区间内全部日体重(蓝、橙黄、紫红点)对日期的回归线,斜率就是 ADG |
| 灰色水平虚线 | — | 分析区间的上下限(stage_range) |
左上角的文字是日增重、回归
R²、adg_type,以及区间从下限长到上限用了多少天。看图时重点看:紫红色点多(区间两端靠曲线填充)、橙黄色点成段出现(中间长时间缺记录)、深灰色叉成片出现(追踪剔除较多,可能是几头猪同时上秤或秤的问题)。
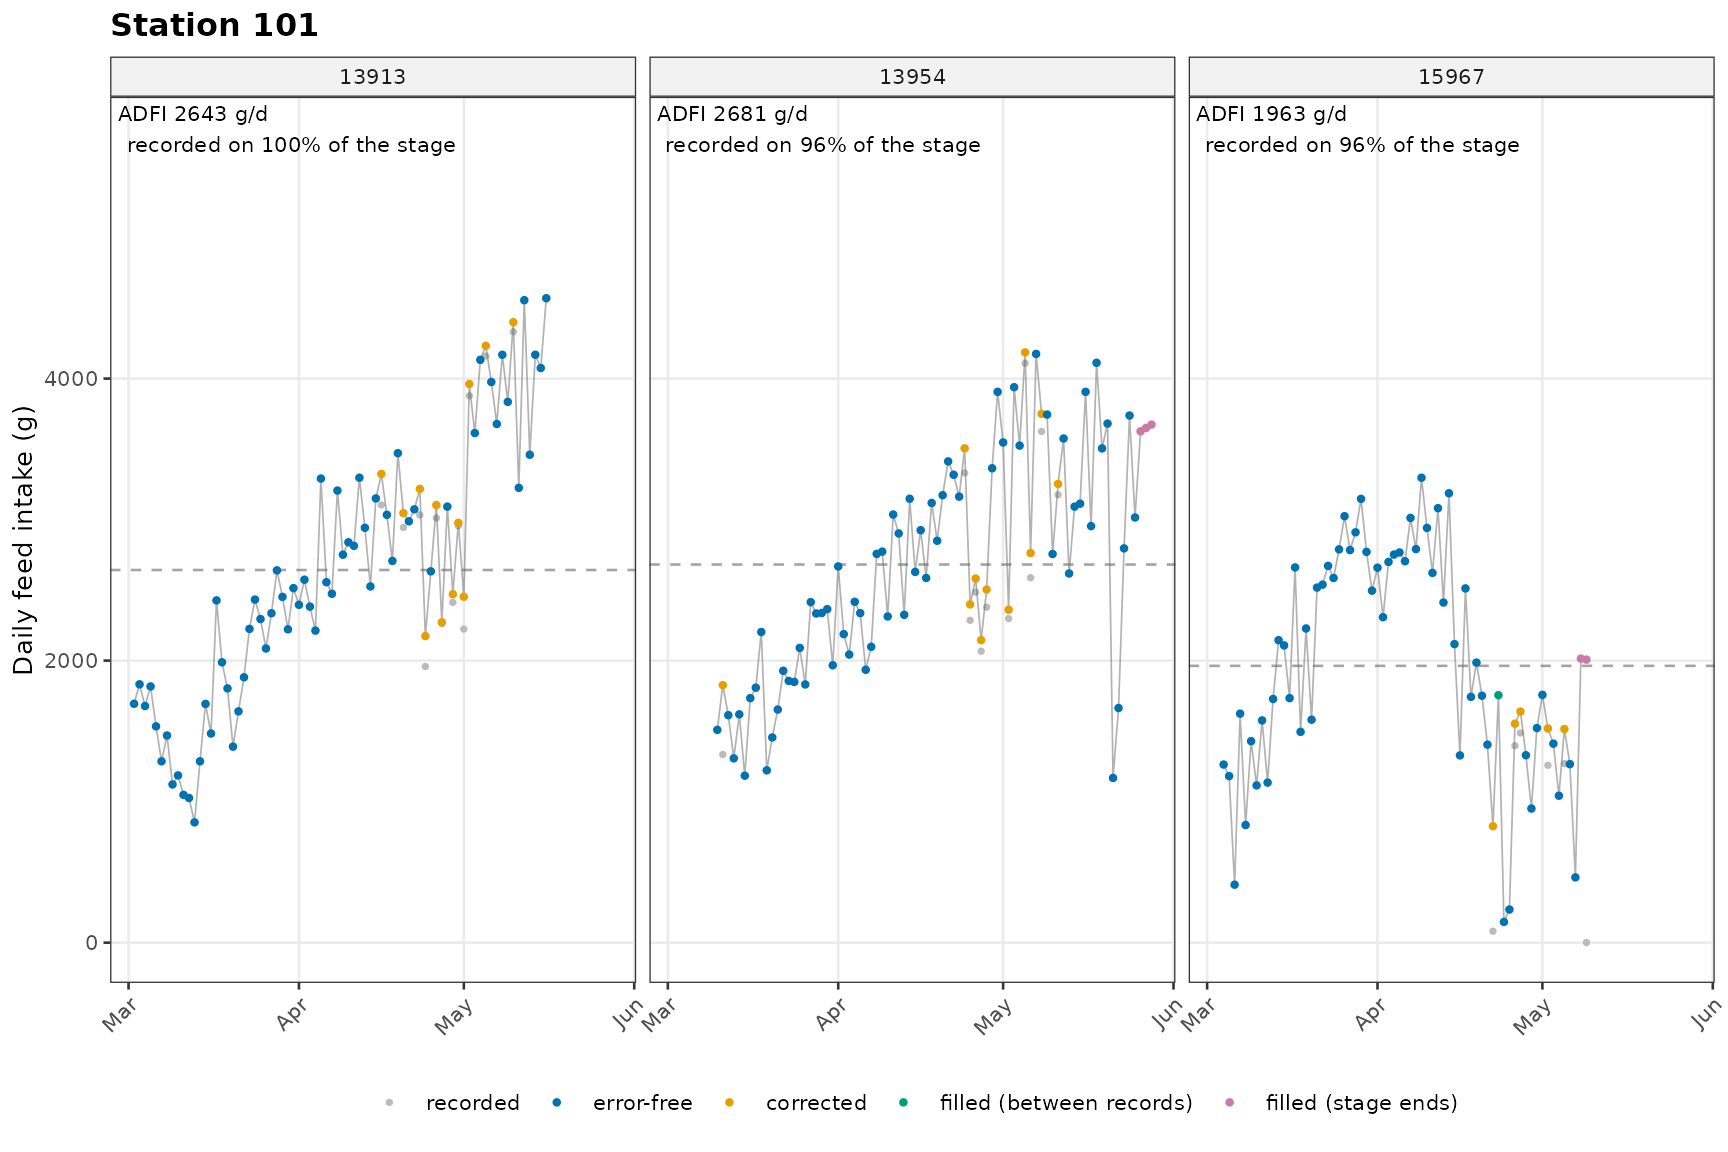
采食量图怎么看
只画区间内的日子:
| 图中元素 | 图例 | 含义 |
|---|---|---|
| 浅灰色点 | recorded | 记录的日采食量(全部访问相加,未校正) |
| 蓝色点 | error-free | 当天没有错误访问,直接使用记录值(state = "org") |
| 橙色点 | corrected | 当天有错误访问,用混合模型校正后的值(corr) |
| 绿色点 | filled (between records) | 两个有记录的日子之间缺失:≤ 3 天 LOESS,> 3 天用群体曲线 ×
个体比例(iii) |
| 紫红色点 | filled (stage ends) | 区间两端缺失:开头用群体曲线 ×
个体比例,末端用单猪回归(elrp) |
| 细灰线 | — | 把最终使用的日采食量(彩色点)按日期连起来 |
| 灰色水平虚线 | — | 这头猪的 ADFI(区间内日采食量的平均值) |
左上角的文字是 ADFI,以及区间内有实测(含校正)采食的天数比例。灰色点和彩色点离得远的日子,说明当天的错误访问多、校正幅度大;紫红色点连成一长段,说明进站晚或出栏早,ADFI 有一部分是推算的。
保存图片
每个测定站输出一张图,每头猪一个分面。保存为图片:
save_plots(g, path = "结果/生长曲线", prefix = "站", suffix = "growth", device = "png")保存图片的时间几乎都花在 ggplot2 绘图上:每个测定站(15 头猪左右)约 1–1.5 秒,与图片格式关系不大。测定站多时可以:
- 用
cores并行保存,例如save_plots(g, path = "结果", cores = 4),耗时大致按核心数缩短; - 只在屏幕上查看时,用
dpi = 150,约快 20%,文件大小约为原来的 1/4; - 用
locations或responders只画需要核查的测定站或猪。
10. HTML 报告
write_report()
把结果写成一个文件夹(index.html 和图片目录
img/),用浏览器打开 index.html
即可,不需要联网:
res <- run_pipeline(nedap)
write_report(res, path = "结果/报告", cores = 4)- 第一页是总览:猪数,ADG、ADFI、FCR 的均值 ± 标准差,所用的质控设置,需要核查的猪(低可信度或被剔除,附原因),以及各测定站的汇总表;
- 之后每个测定站一页:生长曲线图、采食图,以及该站每头猪的 ADG、ADFI、FCR、状态和原因;
- 用键盘左右方向键(或 Page Up / Page Down)翻页,
Home回到总览,End到最后一个站;左侧的站名列表可以直接跳转,有需要核查的猪的站带黄色数字; - 在右上角输入耳号、按回车,会跳到这头猪所在的站,并高亮它的那一行;
- 用浏览器打印(例如另存为 PDF)时,每个站各占一页。
整个文件夹可以直接拷贝或压缩后发给别人。图片默认
dpi = 150;用 locations
可以只生成部分测定站。