tidypptsda 用于处理种猪性能测定站(NEDAP、FIRE)导出的访问记录,计算日增重(ADG)、日采食量(ADFI)和料肉比(FCR)。本文按实际分析的顺序介绍每一步:做什么、输出什么,以及结果怎么读;每个主题的细节见文末列出的各篇文档。常用函数和参数都汇总在一页速查表上,可以打印出来放在手边;这个包为什么这样设计,见《设计思路》。
1. 整体流程
| 步骤 | 函数 | 作用 |
|---|---|---|
| 0 | qc_config() |
设定全部质控参数 |
| 1 | read_station() |
读取测定站导出的 csv(多个文件或整个文件夹) |
| 2 | prep_visits() |
整理为标准访问表 |
| 2+ | add_breed() |
可选:合并你自己的品种(品系)表 |
| 3 | clean_weight() |
体重质控:剔除异常值,判定每头猪是否可用 |
| 4 | calc_adg() |
补齐体重区间内每天的体重,回归斜率即日增重 |
| 5 | flag_feed_errors() |
按 Casey 等(2005)的 16 条规则标记采食错误 |
| 6 | calc_adfi() |
校正日采食量、补齐缺失日,计算 ADFI |
| 7 | calc_fcr() |
料肉比 = ADFI ÷ ADG,并给出可信度标记 |
| 8 |
plot_adg() / plot_adfi() /
save_plots()
|
按测定站出图并保存 |
| 9 | write_results() |
把全部结果表导出为 csv |
| 10 | write_report() |
生成 HTML 报告:每个测定站一页,可以像翻书一样浏览 |
每一步的方法和出处见《计算方法说明》。不需要中间结果时,用
run_pipeline() 一次跑完:
res <- run_pipeline(nedap, verbose = 0)
res
#> ╭  Results NEDAP  ──────────────────────────────────────────────────────────╮
#> │ Pigs   30 in the data · 29 with FCR (23 ok, 6 low confidence) · 1 removed │
#> │ ADG    1205 ± 133 g/d                                                     │
#> │ ADFI   2845 ± 360 g/d                                                     │
#> │ FCR    2.36 ± 0.14                                                        │
#> │                                                                           │
#> │ Check                                                                     │
#> │   13954 (101): weight records cover 5.0 kg of 80-90 kg                    │
#> │   15961 (101): weight records cover 5.2 kg of 70-80 kg                    │
#> │   15967 (101): ADG on part of the stage; weight data flagged              │
#> │   13935 (102): weight records cover 5.0 kg of 60-70 kg                    │
#> │   14937 (102): weight records cover 5.8 kg of 80-90 kg                    │
#> │   ... and 2 more ($fcr$per_pig, $removed)                                 │
#> │                                                                           │
#> │ Next: plot_adg(), plot_adfi(), write_report(), write_results()            │
#> ╰───────────────────────────────────────────────────────────────────────────╯
2. 读入数据
raw <- read_station("D:/测定站导出/2024批次")      # 文件夹下所有 csv/txt/xlsx
visits <- prep_visits(raw)
station 取 "nedap" 或
"fire",不写时按列名自动判断。导出格式不同、表头是中文、需要加入品种时,见《数据准备》。下面直接用包里的示例数据。
3. 质控参数:qc_config()
所有阈值都集中在一个对象里。默认设置:体重先逐日回溯追踪、再用二次稳健回归(rlm)和 LOESS 检测异常值;区间内缺失的体重中间线性插值、两端用二次曲线;采食错误按 Casey 等(2005)判定、按 Jiao 等(2014)校正,缺失的采食短缺口用 LOESS、长缺口和两端用全群”日采食 ~ 体重”曲线 × 个体采食水平;FCR = ADFI ÷ ADG。任意参数都可以覆盖:
最常调整的几个参数:
| 参数 | 含义 | 默认值 |
|---|---|---|
stage_range |
计算 ADG/ADFI/FCR 的体重区间(kg) | 30–120 |
weight_range |
单条体重的有效范围(kg) | 15–150 |
min_test_days |
最少测定天数 | 35 |
max_missing_rate |
最大缺失率(无有效体重的天数比例) | 0.30 |
entry_weight_max / exit_weight_min
|
进站体重上限 / 出栏体重下限(kg),不满足时标记为低可信度 | 65 / 85 |
curve_model |
填充区间两端体重的生长曲线:poly2、poly1、poly3、gompertz | poly2 |
impute_method |
采食填充:loess_pop(≤ 3 天 LOESS;长缺口和开头用群体曲线 × 个体比例;末端用单猪回归)、loess_lm(都用单猪回归)或 linear | loess_pop |
max_extrap_days |
生长曲线最多外推的天数 | 30 |
curve_extrap |
记录范围外怎么外推:start(开头切线、末端曲线)、curve 或 tangent | start |
max_edge_extrap_days |
区间两端填充超过此天数的猪标记为低可信度 | 15 |
duration_max |
单次访问时长上限(s),对应错误类型 OTV-hi | 3600 |
用 print(qc_config())
可以查看全部参数。参数名写错时,函数会提示最接近的正确名称。
4. 逐步分析
4.1 整理访问表
FIRE 示例数据中的猪在 45–60 kg 才进站,因此按《数据准备》中的建议,以 60–120 kg 作为计算区间:
qc_fire <- qc_config(stage_range = c(60, 120))
visits <- prep_visits(fire, qc = qc_fire, verbose = 1)
#>
#> ── Preparing FIRE visits ───────────────────────────────────────────────────────
#>   Visits read                                9,794
#>   └ unidentified (kept, identified = FALSE)     51    0.5%
#>   └ crossing midnight (exit time corrected)     68    0.7%
#>   └ body weight 0 (set to NA)                  478    4.9%
#> ℹ No pig was seen at more than one station
#> ✔ 26 pigs at 2 stations, 9,794 visits over 66 days 0.1s
#> ℹ No breed column. To use breed in the feed intake model and breed-specific limits, add it with `add_breed()`.- 体重和采食量的单位统一为 kg 和 g,时间统一为 UTC。
- 未识别耳标的访问会保留,并标记为
identified = FALSE:计算前后两次访问的料重差、时间差时需要用到它们。 - FIRE 跨零点的访问会自动修正离站时间;体重为 0 的记录视为缺失。
- 一头猪出现在多个站(跑栏、隔离后放错栏等)时,各站的记录都保留,详见《数据准备》。
4.2 体重质控
w <- clean_weight(visits, qc = qc_fire)
#>
#> ── Cleaning body weight (track + rlm + loess) ──────────────────────────────────
#>   Weight records                       9,310
#>   └ outside weight range                  15    0.2%
#>   └ adaptation after entry (not used)  1,069   11.5%
#>   └ outliers                           1,285   13.8%
#>     └ by tracking                         33    0.4%
#> ! Pigs: 23 kept, 2 low confidence, 1 removed 0.4s
head(w$per_pig[, .(responder, n_valid, test_days, missing_rate, status, reason)])
#>    responder n_valid test_days missing_rate status reason
#>       <char>   <int>     <int>        <num> <char> <char>
#> 1:     25822     374        56   0.00000000   keep
#> 2:     35853     417        59   0.00000000   keep
#> 3:     35855     489        59   0.00000000   keep
#> 4:     35862     383        58   0.00000000   keep
#> 5:     35865     353        59   0.01694915   keep
#> 6:     35869     407        59   0.00000000   keep
status 有三种取值:
-
keep:通过质控; -
low_confidence:保留并参与计算,但需要注意,例如进站太重、出栏太轻,原因写在reason中; -
removed:剔除,例如测定天数太短、有效记录太少。
每条体重记录是否为异常值,以及判定的原因,可以在
w$records 中查看。
每头猪进站后头 7
天是适应期(adapt_days = 7),这几天的体重不参与分析(qc_flag = "adaptation")。适应期的采食照常统计:如果这几天已经落在分析区间内(例如
45 kg 进站、区间 30–120 kg),计入 ADFI 和
FCR;如果猪还没到区间下限,则不计入。
异常值检测之前,会先从测定末期往回逐日追踪每头猪的体重。测定站只有四条腿都站上秤才称重,读数偏轻的情况很少;进站初期猪小,常有几头猪同时挤进测定站,读数偏重。末期猪大、只容得下一头,读数最可靠,所以从末期开始往前推,只保留与预测体重衔接的读数(qc_flag = "track")。追踪之后,再用二次稳健回归(rlm,bisquare
权重 < 0.5)和 LOESS 平滑曲线(偏离超过 3
倍稳健标准差)找出零散的异常读数。追踪剔除超过 40% 记录的猪降级为
low_confidence(可能是称重异常,如体重传感器故障);有效体重对
LOESS 平滑曲线的 R² 低于 0.99 的猪也降级。详见《质控参数详解》。
4.3 日增重
adg <- calc_adg(w)
#>
#> ── ADG over 60-120 kg (poly2 curve) ────────────────────────────────────────────
#>   Pigs                                   25
#>   └ observed (stage inside the records)  13   52.0%
#>   └ extrapolated at the ends             12   48.0%
#> ✔ ADG 1207 ± 106 g/d (mean ± SD) 0.3s
head(adg$per_pig[, .(responder, adg_type, adg, r_squared, n_observed_days, n_interpolated_days, n_curve_days)])
#>    responder     adg_type      adg r_squared n_observed_days
#>       <char>       <char>    <num>     <num>           <int>
#> 1:     25822     observed 1245.450 0.9974731              50
#> 2:     35853     observed 1243.582 0.9934323              50
#> 3:     35855     observed 1358.210 0.9951392              44
#> 4:     35862     observed 1172.778 0.9963732              52
#> 5:     35865     observed 1194.068 0.9955332              50
#> 6:     35869 extrapolated 1152.201 0.9976253              39
#>    n_interpolated_days n_curve_days
#>                  <int>        <int>
#> 1:                   0            0
#> 2:                   0            0
#> 3:                   0            1
#> 4:                   0            0
#> 5:                   1            0
#> 6:                   0           14
日增重分三步计算:
- 用剔除异常值后的体重拟合生长曲线(默认二次曲线),求出区间的起止时间:终点是曲线第一次到达上限的时间;起点是在此之前曲线最后一次越过下限的时间;
- 把区间内每一天的体重补齐:有记录的日子用当天中位数;两个有记录的日子之间缺失的,用线性插值;首个有记录日之前、末个有记录日之后的,用生长曲线(晚进站、早出栏时);
- 区间内全部日体重(实测 +
填充)对日期做直线回归,斜率就是日增重,可靠性看
r_squared。
每天的体重和来源在 adg$daily 的
weight_filled、source
列中。adg_type 说明区间两端是否在实测期内:
| adg_type | 含义 |
|---|---|
| observed | 区间两端都在实测期内 |
| extrapolated | 需要用生长曲线外推,但外推不超过 max_extrap_days
|
| partial | 外推后仍到达不了区间端点,只用覆盖到的部分计算 |
| none | 覆盖不足 7 天,不计算 ADG |
4.4 采食错误与日采食校正
adfi <- calc_adfi(visits, adg)
#>
#> ── Flagging feeder errors (Casey et al. 2005) ──────────────────────────────────
#> ✔ 2.62% of 9,743 identified visits with at least one error 0.0s
#>
#> ── ADFI over 60-120 kg ─────────────────────────────────────────────────────────
#> ℹ Correction model: 1487 pig-days, 16 error covariates
#> ℹ Population curve of intake on body weight: all (25 pigs)
#>   Stage pig-days                     1,265
#>   └ recorded without error (org)     1,130   89.3%
#>   └ corrected (corr)                    84    6.6%
#>   └ filled between records (iii)         4    0.3%
#>   └ filled at the stage ends (elrp)     47    3.7%
#>   └ outside dfi_range                    7    0.6%
#> ✔ ADFI 3249 ± 250 g/d (mean ± SD) 0.2s
table(adfi$daily[in_stage == TRUE, state])
#>
#> corr elrp  iii  org
#>   84   47    4 1130
日采食量的校正分两步:
- 校正:对每头猪的每一天,先求”无错误访问的采食量之和” Y,再用混合模型扣除错误项的影响(Jiao 等,2014)。没有错误的日子保持原值不变。
-
填充:只在与 ADG
相同的体重区间内进行。两个有记录的日子之间,连续缺失不超过 3 天的用
LOESS 平滑插补;超过 3
天的、以及区间开头缺失的日子,用全群(有品种时按品种)的”日采食 ~
体重”曲线乘以这头猪自己的采食水平:曲线提供采食随体重变化的形状,个体比例保留这头猪吃得多还是少。区间末端缺失的日子,用这头猪自己的”日采食
~ 体重”线性回归。每个位置用什么方法、由哪个参数控制,见《填充方法》中的逐步演示。体重用的是上一步补齐后的日体重。
qc_config(impute_method = "loess_lm")改用每头猪自己的”日采食 ~ 体重”线性回归;"linear"时,中间改用线性插值。
state 列标明每一天的来源:
-
org:原始记录,当天没有错误访问; -
corr:经过校正; -
iii:在两个有记录的日子之间填充; -
elrp:在区间两端填充; -
missing:无法估计。
校正模型的系数保存在 adfi$model
中;各类错误的发生率可以这样查看:
f <- flag_feed_errors(visits, verbose = 0)
attr(f, "error_rates")[n > 0, .(label, n, rate = round(100 * rate, 2))]
#>             label     n  rate
#>            <char> <num> <num>
#>  1:        FIV-lo    33  0.34
#>  2:        FIV-hi    21  0.22
#>  3: FRV-hi-strict     4  0.04
#>  4:        FRV-hi    28  0.29
#>  5:         FRV-0     1  0.01
#>  6:        FRV-lo    64  0.66
#>  7:        LWD-lo     5  0.05
#>  8:        LWD-hi    60  0.62
#>  9:        FWD-lo     4  0.04
#> 10:        FWD-hi    60  0.62
4.5 料肉比
fcr <- calc_fcr(adg, adfi)
#>
#> ── FCR over 60-120 kg ──────────────────────────────────────────────────────────
#>   Pigs with FCR     25
#>   └ ok              21   84.0%
#>   └ low confidence   4   16.0%
#> ✔ FCR 2.70 ± 0.16 (mean ± SD) 0.0s
head(fcr$per_pig[, .(responder, adg, adfi, fcr, fcr_flag, fcr_note)])
#>    responder      adg     adfi      fcr       fcr_flag
#>       <char>    <num>    <num>    <num>         <char>
#> 1:     25822 1245.450 3200.402 2.569674 low_confidence
#> 2:     35853 1243.582 3220.840 2.589970             ok
#> 3:     35855 1358.210 3875.918 2.853695             ok
#> 4:     35862 1172.778 3243.419 2.765586             ok
#> 5:     35865 1194.068 3157.321 2.644172             ok
#> 6:     35869 1152.201 3476.420 3.017200             ok
#>                                   fcr_note
#>                                     <char>
#> 1: weight records cover 5.1 kg of 70-80 kg
#> 2:
#> 3:
#> 4:
#> 5:
#> 6:
fcr$summary[group == "all", lapply(.SD, function(x) if (is.numeric(x)) round(x, 2) else x)]
#>     group        trait     n     min     max  median    mean     sd    cv
#>    <char>       <char> <num>   <num>   <num>   <num>   <num>  <num> <num>
#> 1:    all          adg    25  939.78 1455.93 1205.57 1207.25 105.83  0.09
#> 2:    all         adfi    25 2591.20 3875.92 3220.84 3249.31 250.38  0.08
#> 3:    all          fcr    25    2.35    3.02    2.67    2.70   0.16  0.06
#> 4:    all           gf    25    0.33    0.42    0.37    0.37   0.02  0.06
#> 5:    all   stage_days    25   40.43   63.35   48.94   49.65   4.75  0.10
#> 6:    all start_weight    25   60.00   60.00   60.00   60.00   0.00  0.00
#> 7:    all   end_weight    25  120.00  120.00  120.00  120.00   0.00  0.00
fcr_flag = "low_confidence" 的原因写在
fcr_note 中,常见的有:
- 体重或采食量在区间开头或结尾填充超过 15 天,通常是进站太晚或出栏太早;
- ADG 只覆盖了区间的一部分;
- 区间内实测采食的天数不足 70%;
- 中间某个 10 kg 体重段的体重记录覆盖不足 6 kg(记录断档);
- 设置了
bin_fcr_limits时,某一段的料肉比超出了合理范围。
每头猪每个 10 kg 体重段的采食量、增重和分段料肉比保存在
fcr$by_bin 中,可以用来定位问题出在哪一段:
head(fcr$by_bin[, .(responder, weight_from, weight_to, feed_kg = round(feed_kg, 1),
                    gain_kg = round(gain_kg, 1), fcr = round(fcr, 2), weight_coverage_kg = round(weight_coverage_kg, 1))])
#> Key: <responder>
#>    responder weight_from weight_to feed_kg gain_kg   fcr weight_coverage_kg
#>       <char>       <num>     <num>   <num>   <num> <num>              <num>
#> 1:     25822          60        70    22.1     9.7  2.27                9.1
#> 2:     25822          70        80    23.8     9.8  2.43                5.1
#> 3:     25822          80        90    25.7     9.9  2.60                8.1
#> 4:     25822          90       100    28.4     9.9  2.85                9.2
#> 5:     25822         100       110    30.1    10.0  3.00                8.1
#> 6:     25822         110       120    23.7    10.1  2.35                8.0
5. 出图、导出与报告
g <- plot_adg(adg, weight = w, responders = c("35853", "35855", "35877"))
#> ✔ Created 1 growth plot
g$plot[[1]]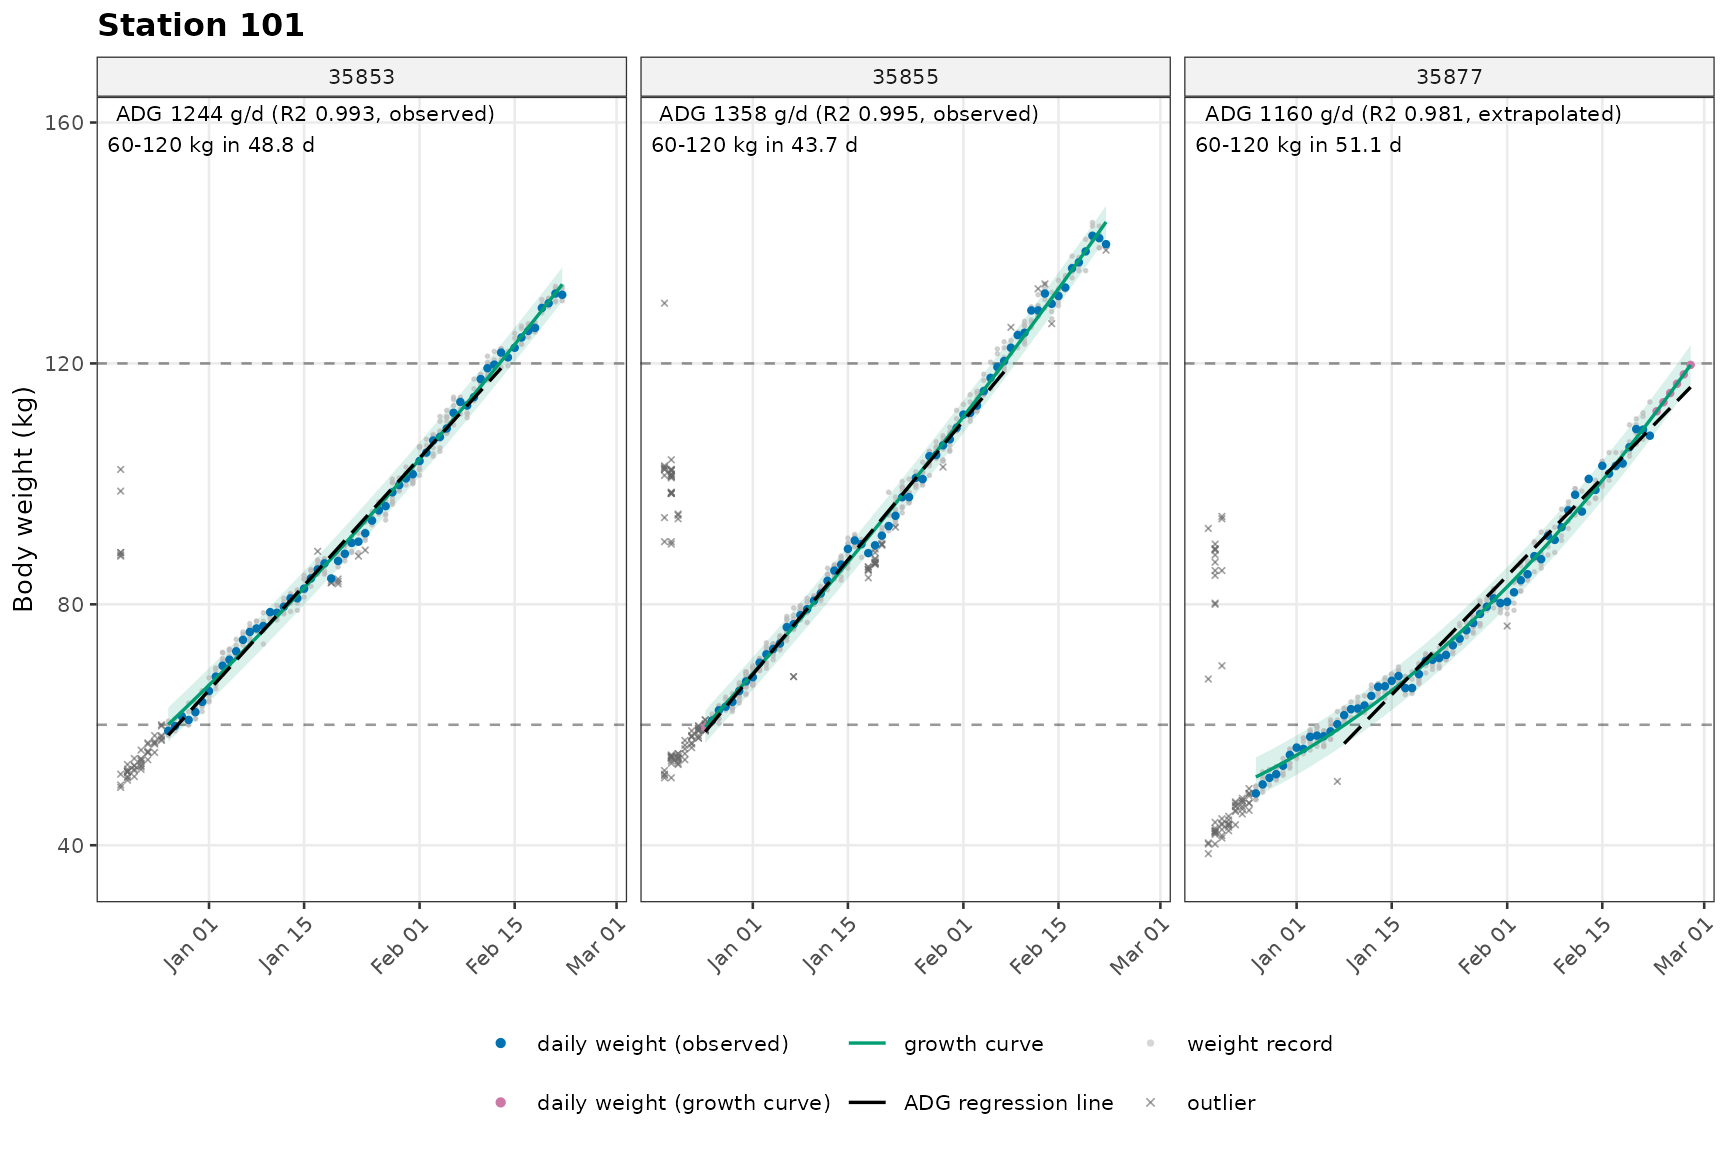
save_plots(g, path = "结果/生长曲线", suffix = "growth")   # 每个测定站一张图
write_results(res, dir = "结果", farm = "A01")            # 全部结果表导出为 csv
write_report(res, path = "结果/报告")                     # HTML 报告,每个站一页
图怎么看、每张表每一列的含义、HTML 报告怎么用,见《结果、图表与报告》。猪多时可以用
cores 并行,见《运行提示、并行与速度》。
6. 下一步
| 想做什么 | 看哪篇 |
|---|---|
| 读入自己的数据、加入品种、提高数据质量 | 《数据准备》 |
| 调整阈值和方法 | 《质控参数详解》 |
| 了解每一步的方法和出处 | 《计算方法说明》、《填充方法》 |
| 看懂结果、出图、导出、生成报告 | 《结果、图表与报告》 |
| 在自己的数据上比较方法和参数 | 《验证函数使用指南》、《方法验证》 |
| 加速、看懂运行提示 | 《运行提示、并行与速度》 |
| 这个包为什么这样设计 | 《设计思路》 |
| 安排测定站进苗:全进全出、衔接进苗、分组滚动 | 进苗规划工具 |
在育种评估中,建议优先使用 fcr_flag = "ok"
的个体;低可信度的个体可以单独核查,或在模型中加以区分。
7. 常见问题
问:为什么 ADFI 比实测记录的平均值低?答:ADFI 是整个体重区间内的平均值,包括体重较小、采食较少的前期;实测记录可能只覆盖了体重较大的后期。
问:旧版本的函数还能用吗? 答:从 0.3.0
起,preprocess_data()、adg_get()
等旧函数名已删除,请改用本文介绍的新函数;从 1.0.0
起,预设(qc_config("national")
等)、calc_fcr() 的累计采食法和 plot_cfi()
已删除。需要旧版行为时,可安装
0.1.0:pak::pak("tony2015116/tidypptsda@v0.1.0")。
问:如何只分析某个测定站或某几头猪?答:可以在
prep_visits() 之后筛选,例如
visits[location == "101"];作图时用locations
和 responders 参数指定。
参考文献
- Casey, D. S., Stern, H. S., & Dekkers, J. C. M. (2005). Identification of errors and factors associated with errors in data from electronic swine feeders. Journal of Animal Science, 83, 969-982.
- Jiao, S., Maltecca, C., Gray, K. A., & Cassady, J. P. (2014). Feed intake, average daily gain, feed efficiency, and real-time ultrasound traits in Duroc pigs: I. Journal of Animal Science, 92, 2377-2386.